
Verstoß oder Prüfhinweis: Warum jeder Verstoß jetzt einen Beleg trägt
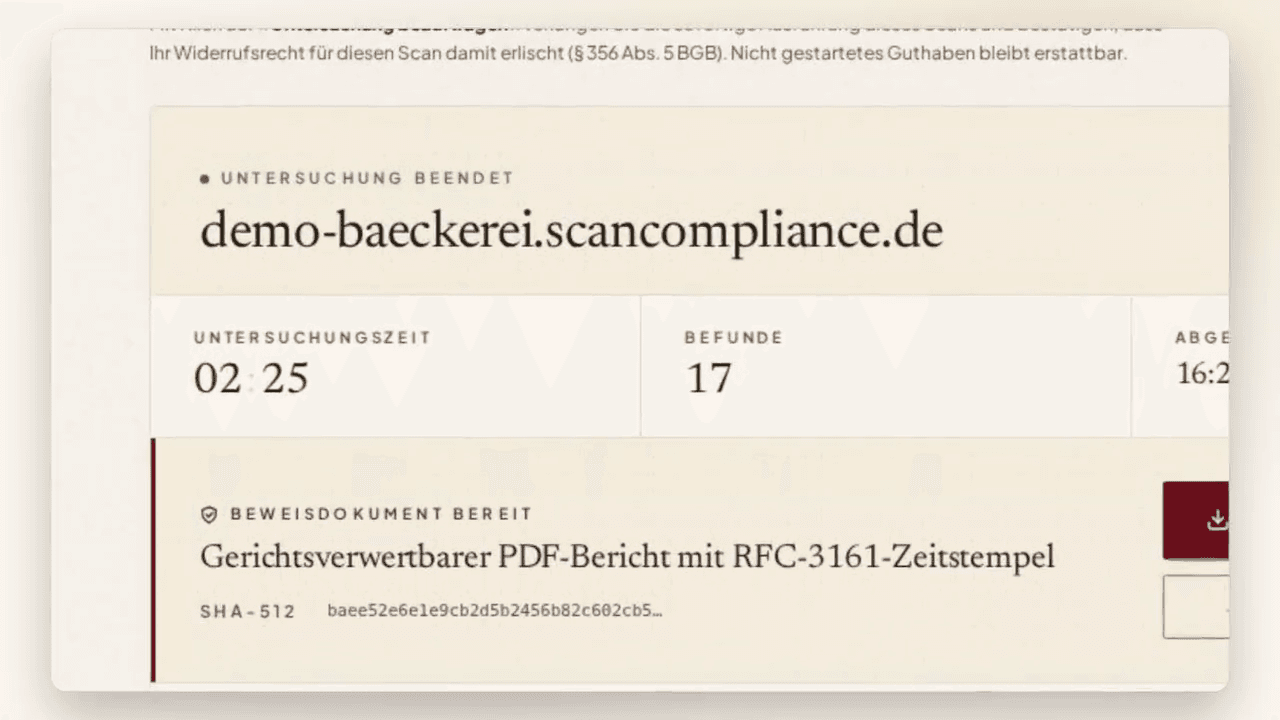
Ein Scan-Bericht ist nur so viel wert wie das, was hinter jedem Eintrag steht. Seit dem 28. September 2026 bewertet unser Scanner einen Befund nur dann als Verstoß, wenn er dazu einen gespeicherten Beleg hat: eine Messung aus dem Seitenaufruf, die man nachlesen kann. Alles, was eine KI aus Texten ableitet, ohne dass eine Messung es stützt, erscheint seither als Prüfhinweis. Dieser Beitrag erklärt, was das in der Praxis bedeutet und warum wir diesen Weg gewählt haben.
Zwei Stufen statt einer Liste
Ein Bericht enthält seit dem Umbau zwei klar getrennte Arten von Befunden:
- Verstoß: Der Scanner hat die Lage selbst gemessen und das Ergebnis gespeichert. Beispiel: Ein Tracking-Aufruf an einen Werbedienst ging vor dem ersten Klick im Cookie-Banner hinaus. Der Beleg ist die HTTP-Spur mit Zeitpunkt, Ziel und Auslöser.
- Prüfhinweis: Es gibt einen begründeten Verdacht, aber keine eigene Messung. Beispiel: Die Datenschutzerklärung nennt keinen Verantwortlichen, so wie die KI den Text liest. Das kann stimmen, es kann aber auch an einer ungewöhnlichen Gliederung liegen. Hier schauen Sie selbst nach.
Früher konnte ein Befund allein auf der Aussage einer KI zum Verstoß werden. Das war in den meisten Fällen richtig, aber nicht in allen. Für ein Dokument, das Sie Ihrer Agentur, Ihrem Anwalt oder im Ernstfall einer Behörde vorlegen, ist „meistens richtig“ zu wenig.
Was ein Beleg ist
Ein Beleg ist immer eine Messung aus dem Seitenaufruf, die der Scanner selbst vorgenommen und gespeichert hat. Dazu gehören:
- die vollständige HTTP-Spur des Aufrufs, also jede Anfrage mit Ziel und Zeitpunkt,
- das Cookie-Inventar vor und nach der Einwilligung,
- der Zustand der Schalter im Cookie-Banner, etwa ob „Marketing“ schon vorab aktiviert war,
- Bildschirmaufnahmen und der Quelltext der Seite zum Zeitpunkt des Scans,
- ein RFC-3161-Zeitstempel und ein SHA-512-Hash über das Beweisdokument.
Jeder Verstoß im Bericht verweist auf den Teil des Belegs, aus dem er folgt. Sie müssen uns nicht glauben, Sie können nachlesen.
Wo KI mitarbeitet und wo nicht
Vieles auf einer Website lässt sich messen: Aufrufe, Cookies, Zertifikate, Schalter. Anderes steht in Texten, etwa ob ein Impressum vollständig ist oder ob die Datenschutzerklärung einen Dienst nennt, der auf der Seite tatsächlich läuft. Für diese Textfragen setzen wir ein Sprachmodell ein, das Kandidaten für Befunde liefert.
Seit dem 1. Oktober 2026 prüft ein zweites, unabhängiges Modell jeden dieser Kandidaten gegen die gemessenen Fakten des Scans, bevor er in den Bericht kommt. Bestätigt es den Befund und gibt es dazu eine Messung, wird er zum Verstoß. Gibt es keine Messung, bleibt er ein Prüfhinweis, auch wenn beide Modelle sich einig sind. Diese Regel ist bewusst streng: Eine KI, die eine andere KI bestätigt, ist noch kein Beleg.
Was sich für Website-Betreiber ändert
Wir haben dieselben Websites mit dem alten und dem neuen Verfahren geprüft. Die Zahl der Verstöße je Website bleibt gleich, die Zahl der Prüfhinweise nimmt leicht zu, und ein Scan ist im Mittel um etwa ein Sechstel schneller fertig. Der Unterschied liegt in der Herkunft: Im alten Verfahren beruhten einzelne Verstöße allein auf der Einschätzung der KI. Im neuen Verfahren trägt jeder Verstoß einen gemessenen Beleg.
Ein Beispiel aus der Abnahme: Auf einer Website mit Cookiebot-Banner waren die Zwecke „Präferenzen“, „Statistiken“ und „Marketing“ schon vorab angekreuzt. Der Scanner liest diese Schalter jetzt auch dann zuverlässig, wenn das Banner seine Beschriftungen erst über zugeordnete Label-Elemente anhängt. Der Befund „Cookie-Banner mit vorab aktivierten Zwecken“ steht deshalb als Verstoß im Bericht, mit dem gemessenen Schalterzustand als Beleg.
Was Sie mit einem Prüfhinweis tun
Ein Prüfhinweis ist keine Entwarnung und kein Urteil. Er sagt: Hier lohnt ein Blick. Lesen Sie die genannte Stelle, vergleichen Sie sie mit der Empfehlung im Bericht, und entscheiden Sie selbst oder mit anwaltlicher Hilfe. Wenn Sie den Punkt beheben, verschwindet er beim nächsten Scan. Wenn er unbegründet war, ignorieren Sie ihn, ohne dass er Ihre Verstoßzahl verändert hat.
Diese Trennung ist der Kern der Methodik: Was wir behaupten, belegen wir. Was wir vermuten, kennzeichnen wir als Vermutung.
Lars Neujeffski
Gründer von ScanCompliance.de. Entwickelt den forensischen Compliance-Scanner, der Websites automatisiert auf über 44 Prüfpunkte zu DSGVO, TDDDG, DDG und BFSG untersucht — die technischen Beispiele in dieser Wissensbank stammen aus realen, anonymisierten Scan-Ergebnissen.